从模糊提问
到可信报告
基于 LangGraph 的企业问数 Agent:混合检索、反问澄清、沙盒执行、反幻觉报告生成——每一步都有确定性约束,每个数字可溯源,将「提需求-排期-出报表」压缩为即时自助式分析。
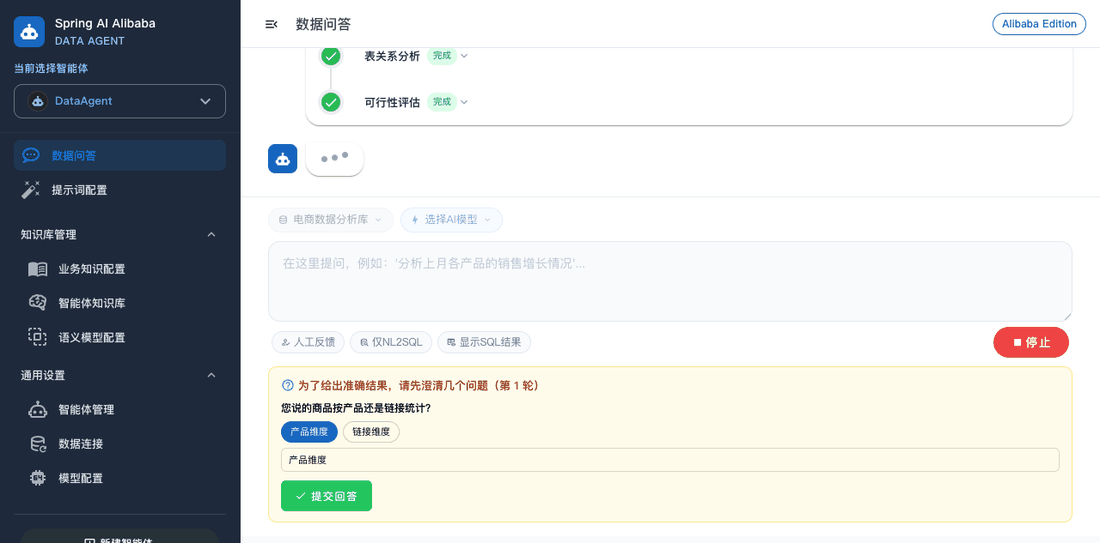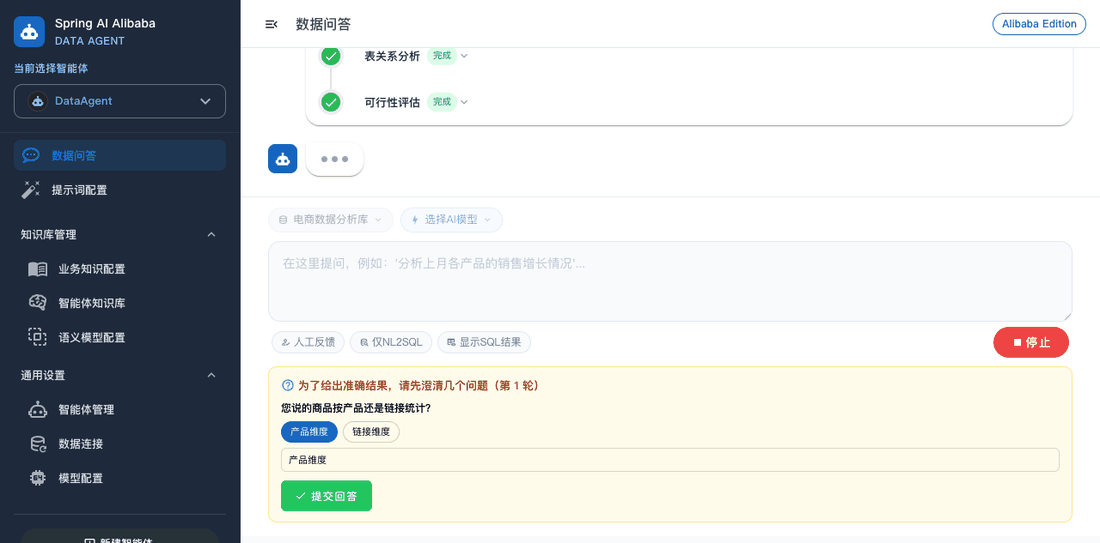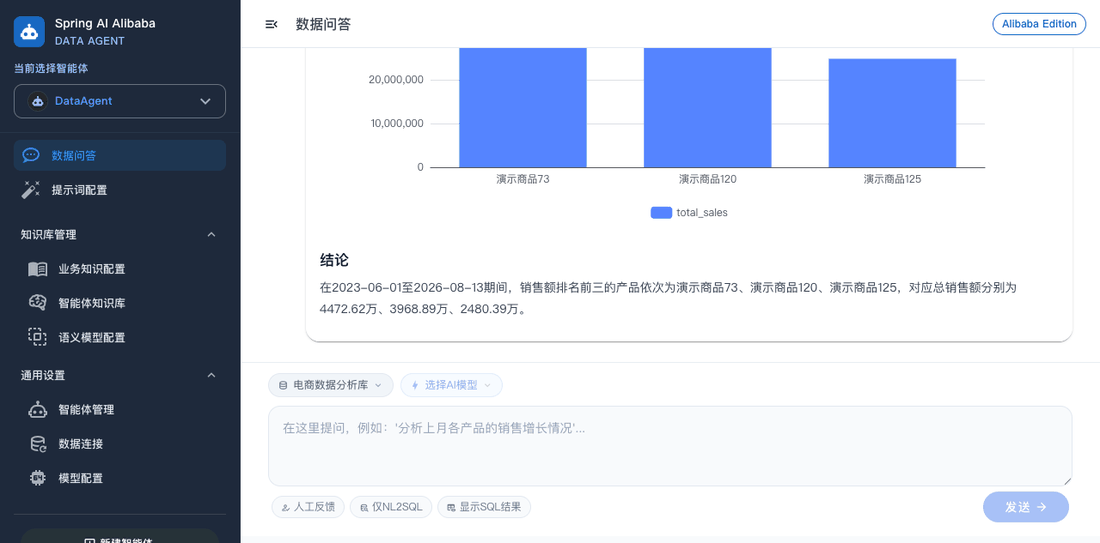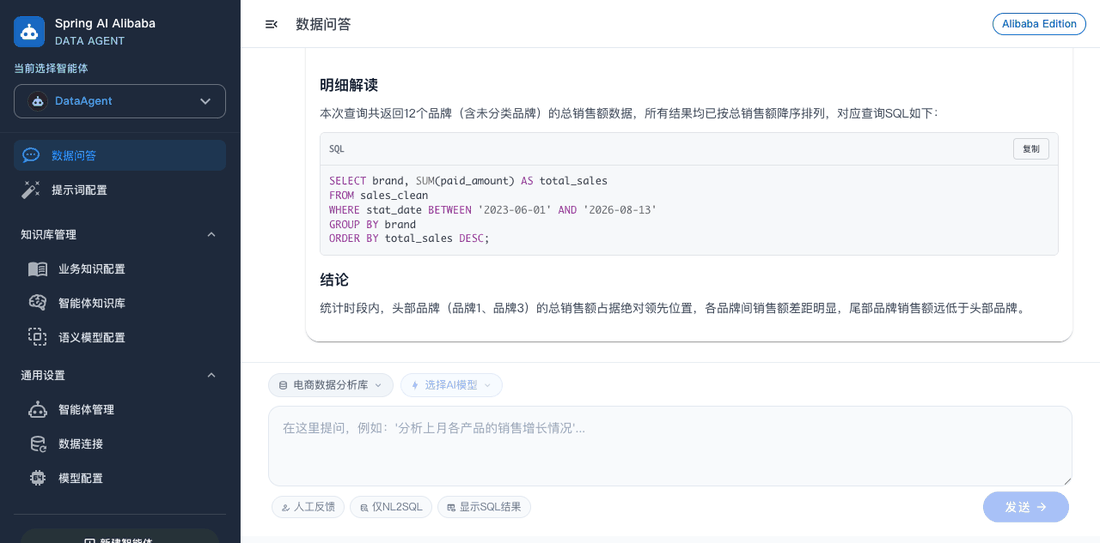
反问澄清 → 口径确认 → 同会话续跑 → 流式报告与图表(演示数据,预录)
基于 LangGraph 的企业问数 Agent:混合检索、反问澄清、沙盒执行、反幻觉报告生成——每一步都有确定性约束,每个数字可溯源,将「提需求-排期-出报表」压缩为即时自助式分析。
每一个子系统都对应一个明确的失效模式:口径歧义、检索盲区、数字编造、SQL 错写、单轮波动、执行安全。
确定性歧义词护栏 + LLM 可行性评估双出口;LangGraph interrupt 挂起,结构化问题卡片确认口径后同会话续跑。
Qdrant 向量召回与 BM25 词面召回并行,RRF 融合排序;7 类分型知识条目由数据治理过程生成。
上下文包注入(问题 · 口径 · 计划 · 每步 SQL 与 TopN 行);LLM 选图、代码注数;反幻觉规则约束事实边界。
均值、中位数、分布、相关性等 SQL 难以表达的统计,由 LLM 生成代码、Docker 容器隔离执行。
Tier1 SQL 执行对比(golden + 多数决);Tier2 报告质量评分(数字溯源硬检查 + LLM 软评)。
Caddy basic_auth 整站门禁;demo schema 与真实数据隔离;Docker Compose 一键起停。
兼容 Spring AI Alibaba DataAgent 的 SSE 协议与节点语义,前端零适配复用。
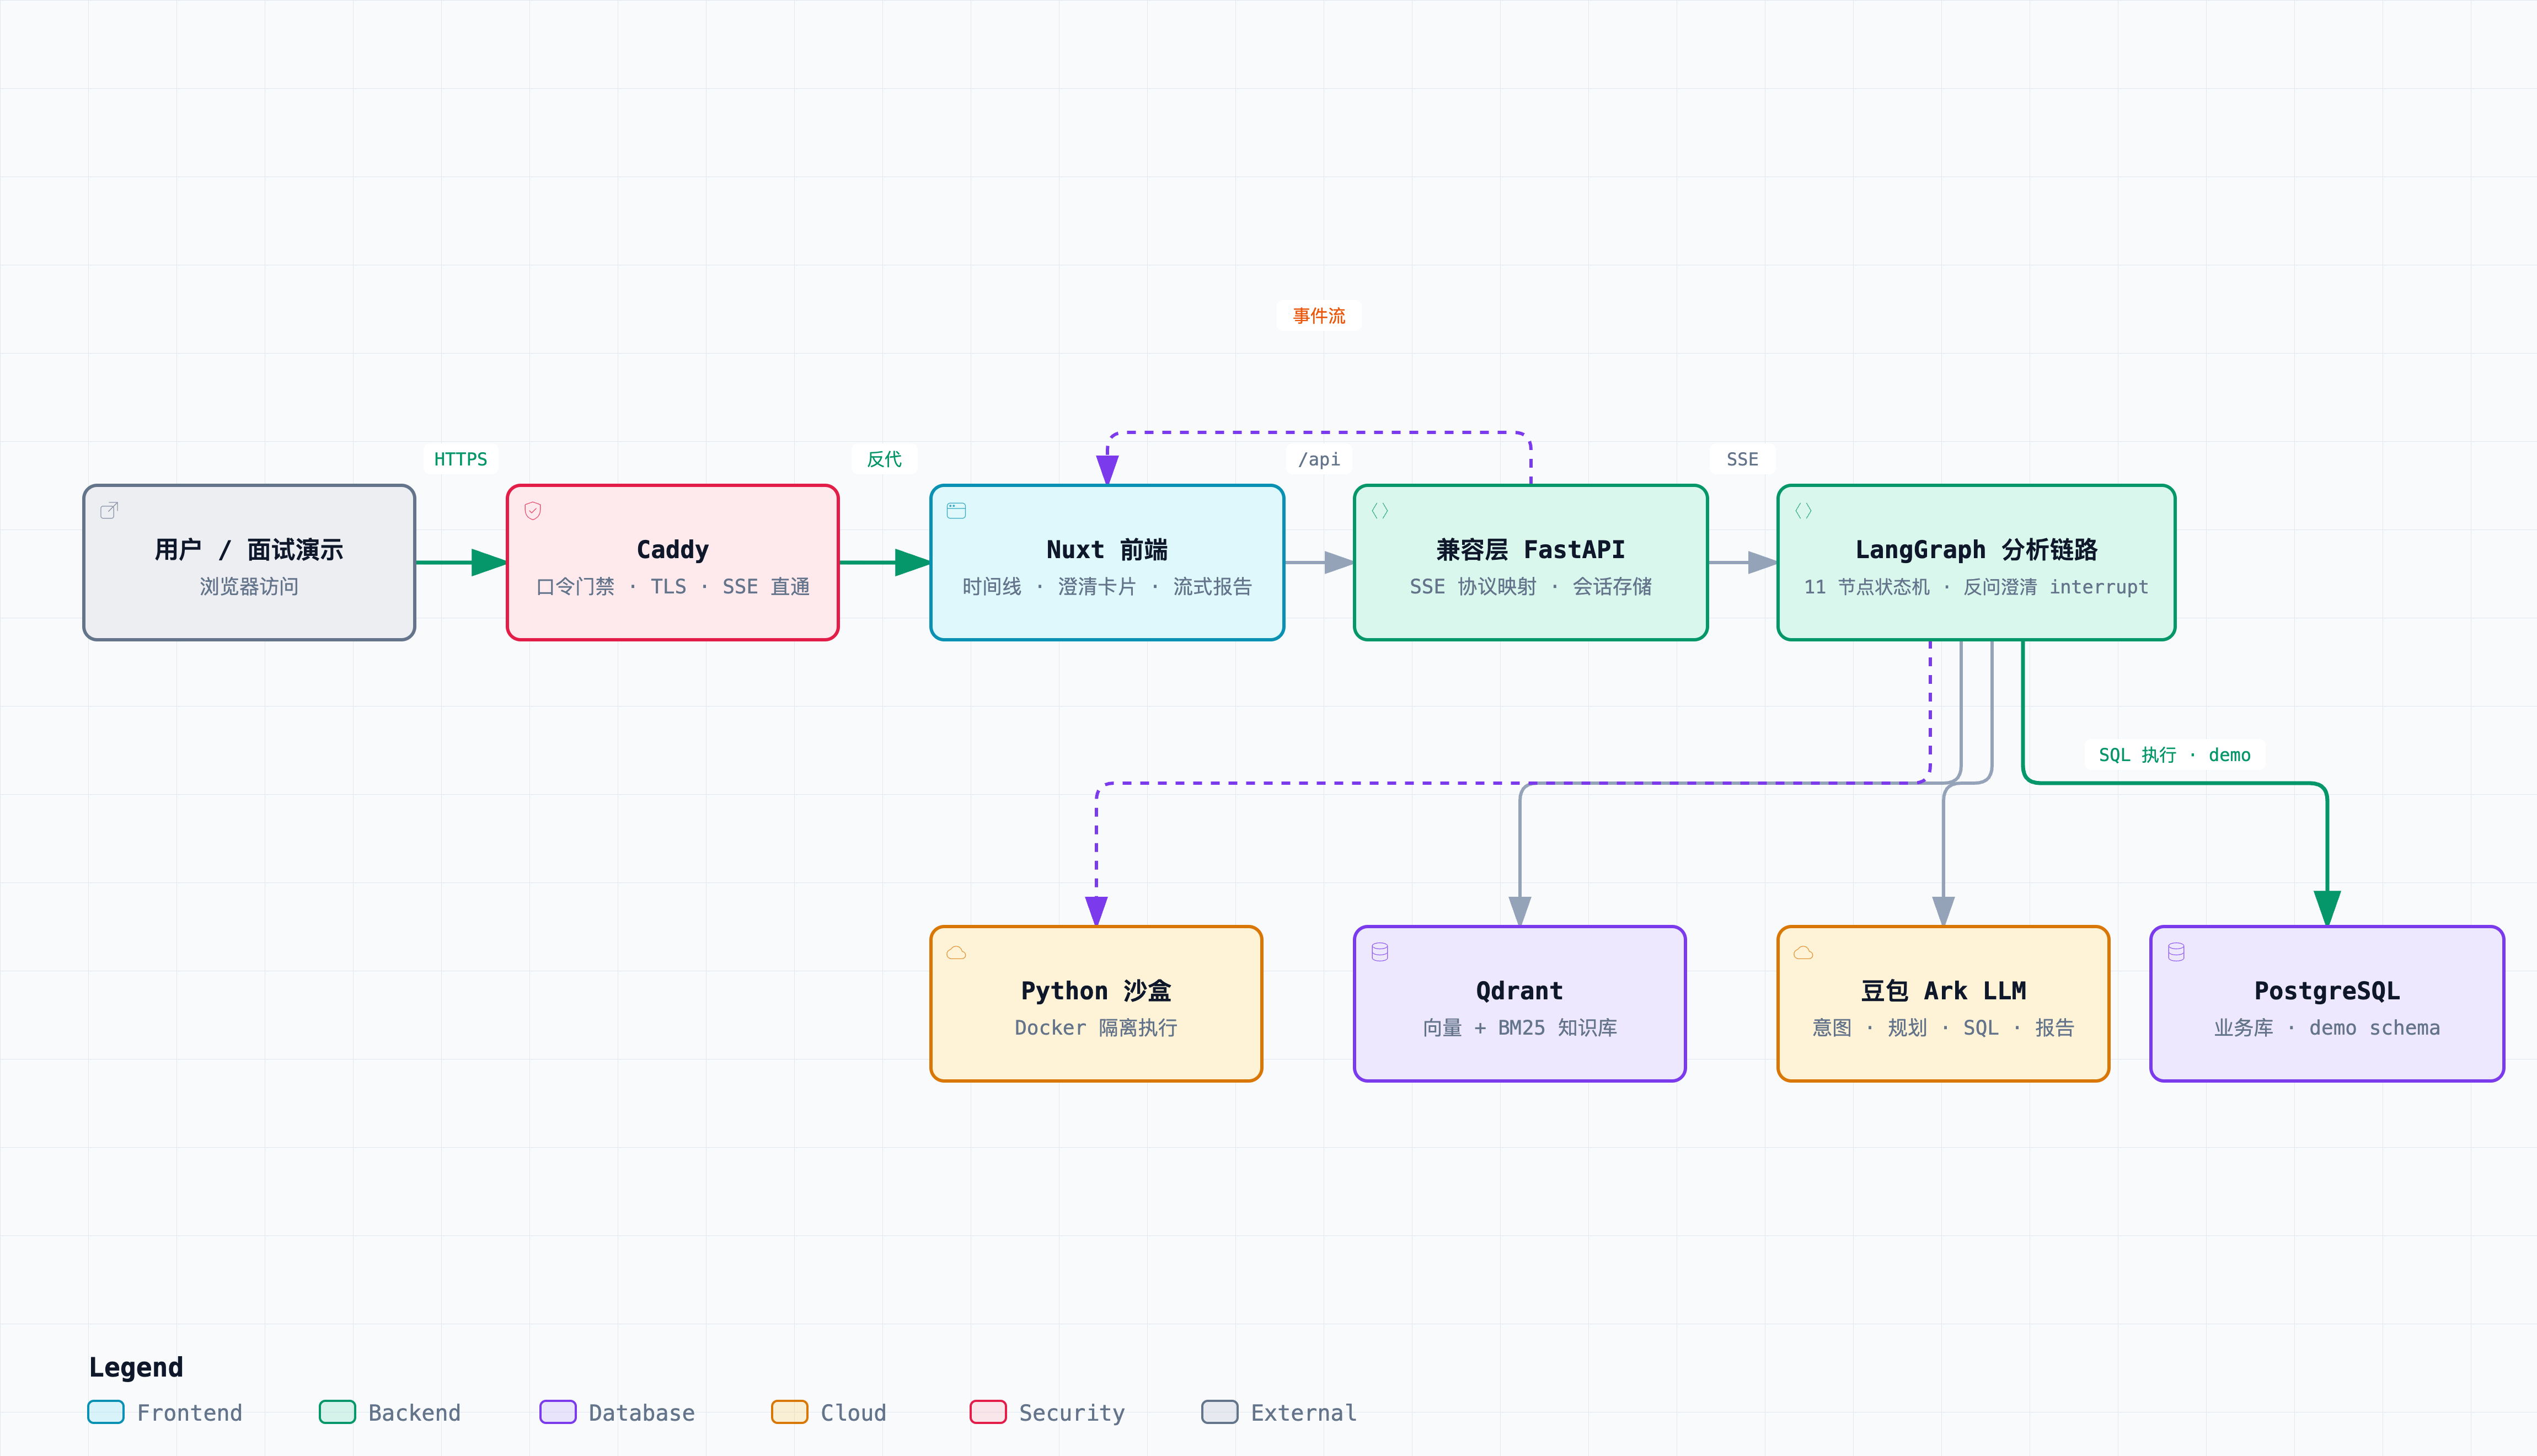
请求路径:用户 → Caddy(口令门禁)→ Nuxt 前端 → 兼容层 FastAPI(SSE 协议映射 · SQLite 会话)→ LangGraph 分析链路(11 节点状态机)→ PostgreSQL / Qdrant / 豆包 Ark LLM / Docker 沙盒。
🔗 打开交互式版本(视图聚焦 · 路径追踪 · 演示模式) | 分析管线交互版
11 节点主链全貌:意图识别 → 证据召回 → 查询增强 → Schema 召回 → 表关系推理 → 可行性评估 → 执行规划 → SQL 生成 → 语义校验 → SQL 执行 → 报告生成;反问澄清与 Python 沙盒两条条件支线在图中以虚线呈现。
每个决策对应一个明确的失效模式,原则是:能用确定性代码约束的,不交给模型。
评测对象、方法与当前结果。Tier1 与 Tier2 的一致性标准不同:SQL 有标准答案,对比从严;报告没有标准答案,底线是无中生有。Tier2 采用数字溯源硬检查(60%)+ LLM 软评(40%)混合打分,配 25% 量级否决;经 8 轮回归迭代,硬检查通过率 82% → 99%、软评均分 91 → 99。
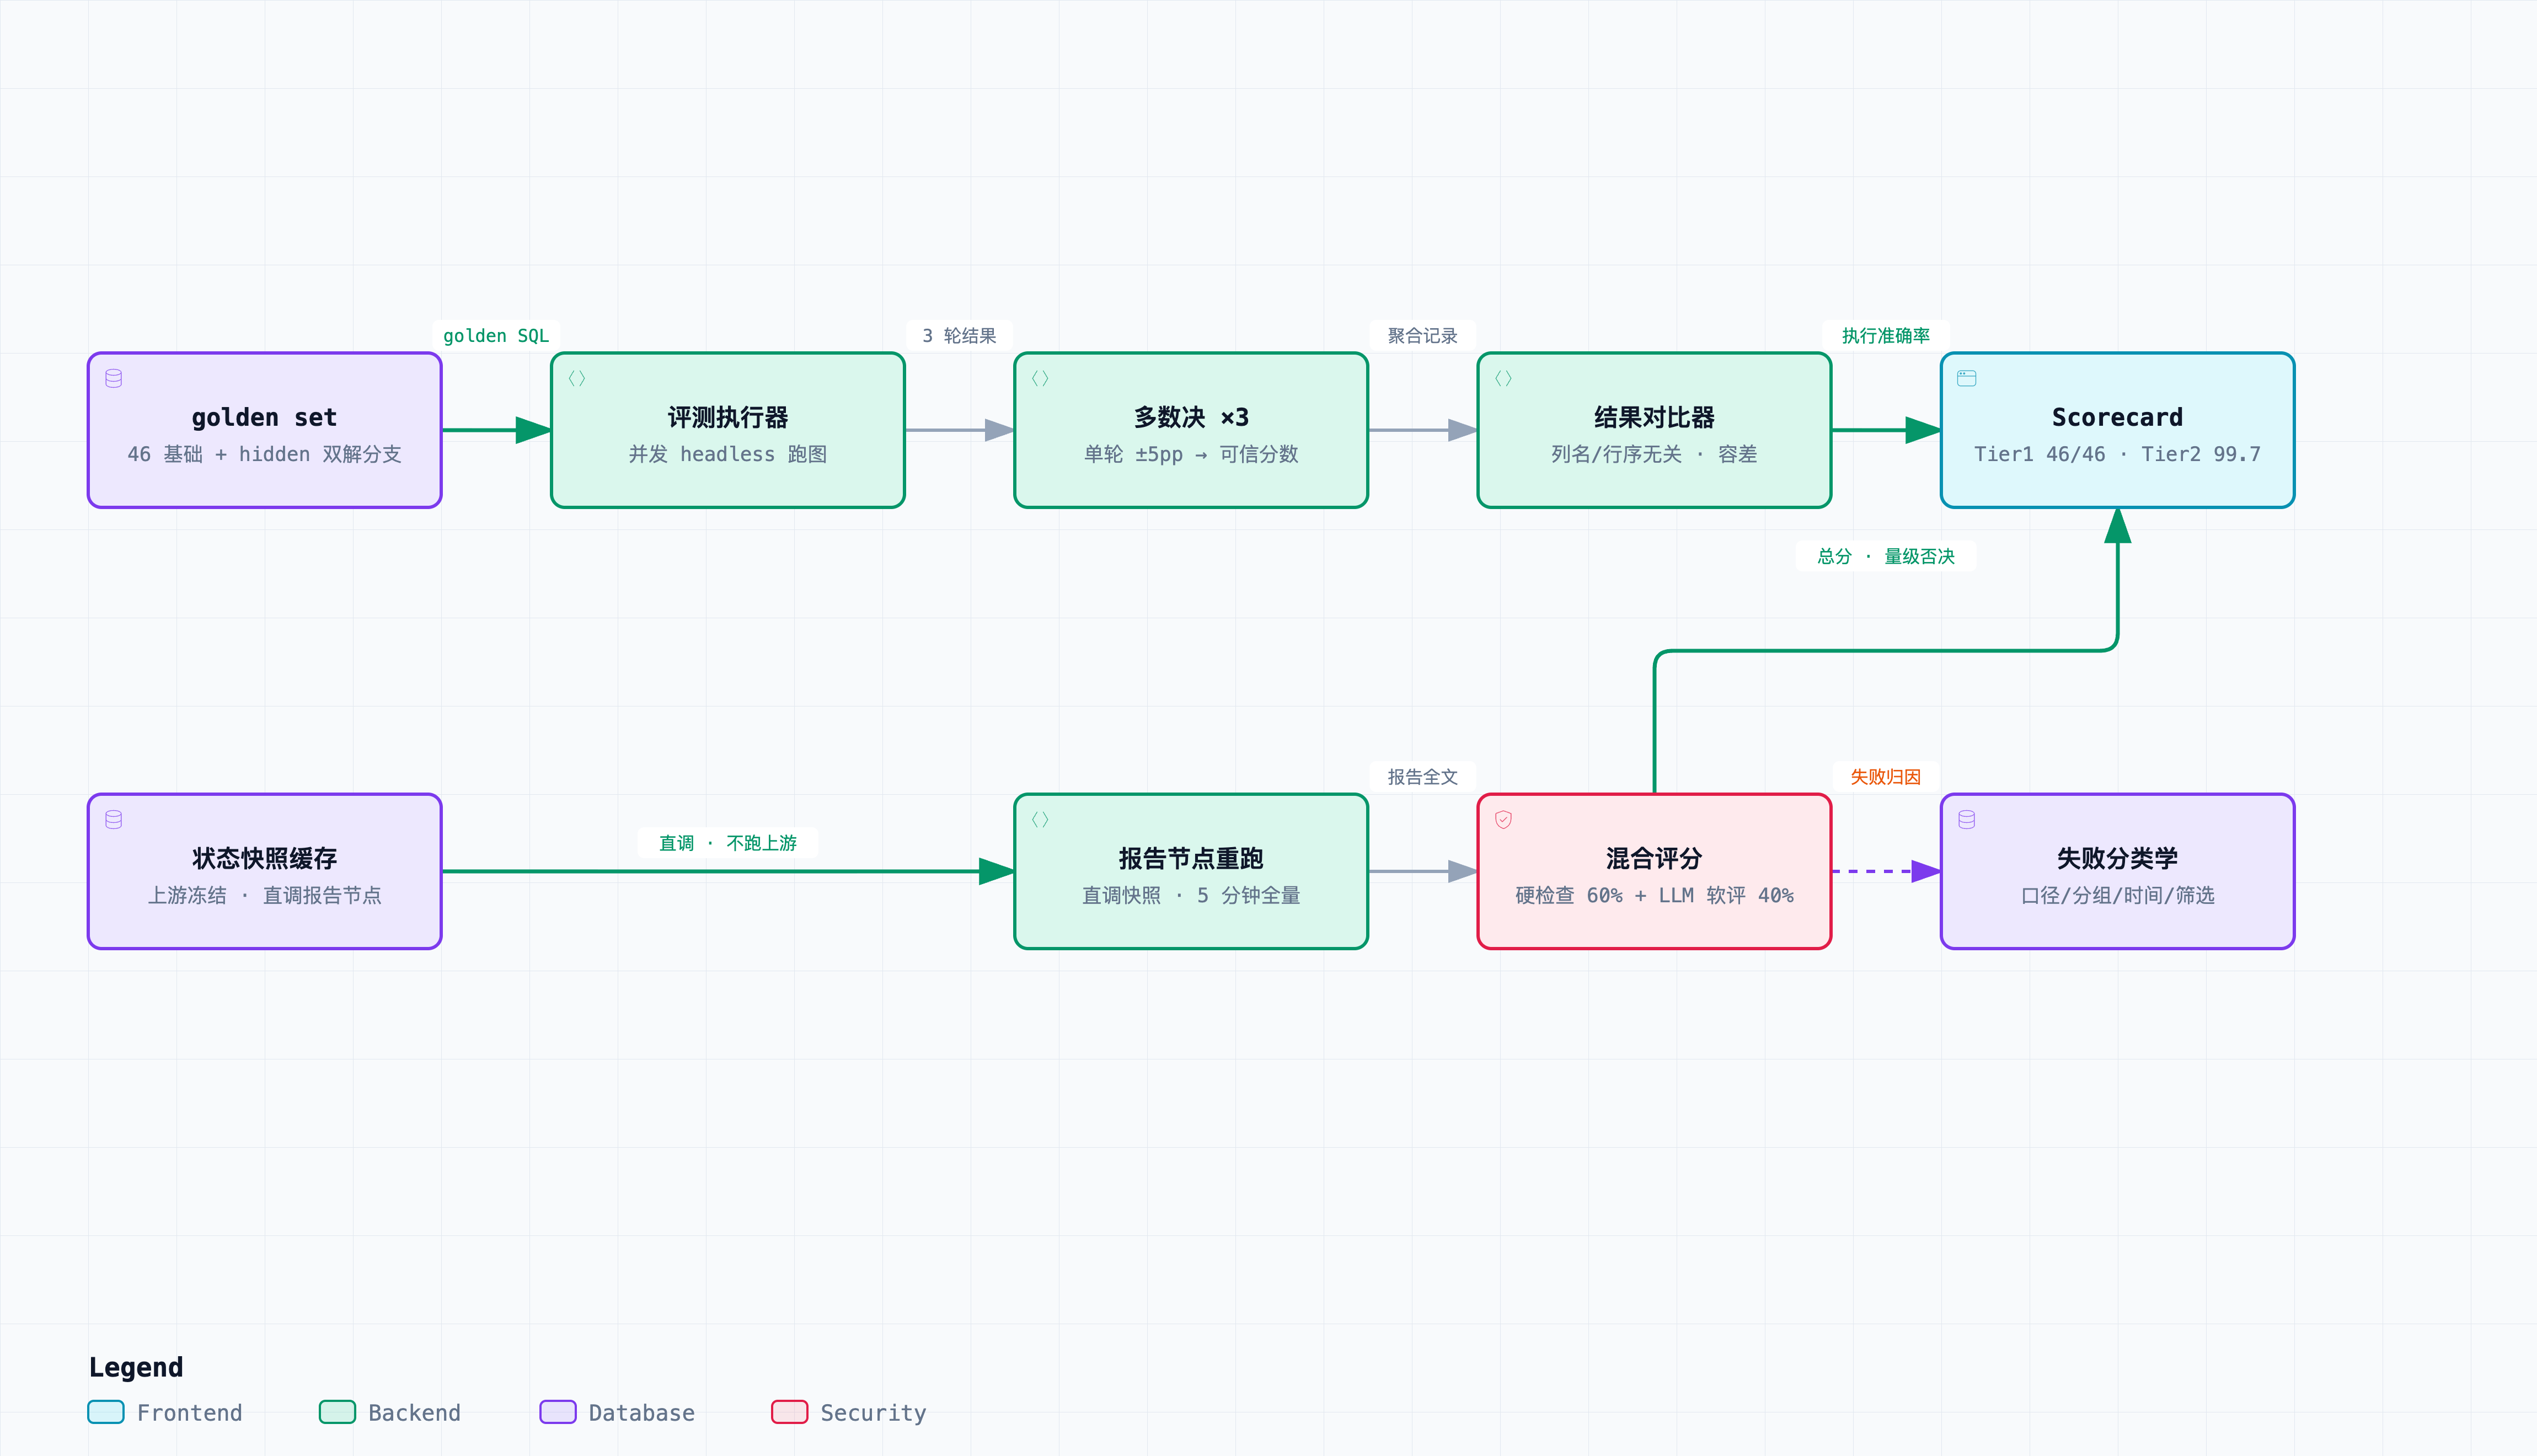
结论的局限已声明:SQL 生成与报告撰写依赖 LLM,存在单轮波动;多数决与确定性护栏用于约束该波动。评测脚本与 golden 定义见仓库。
三个预录会话的完整 SSE 帧回放——时间线、澄清卡片、流式报告与图表,按真实时间轴重现。点击进入,播放器支持暂停与倍速。